
Niveau : Débutant
Durée : 50 – 60 min
Module : Support utilisateur TIP
Toutes les demandes adressées au support informatique n’ont pas la même importance.
Une imprimante individuelle indisponible, une application métier inaccessible pour tout un service ou une panne réseau affectant un site entier doivent être traitées différemment.
Le technicien doit donc être capable d’évaluer l’impact et l’urgence afin de déterminer la priorité du ticket.
🎯 Objectifs
À la fin de ce cours, tu seras capable de :
- différencier impact, urgence et priorité ;
- évaluer l’impact d’un incident ;
- évaluer son niveau d’urgence ;
- comprendre le principe d’une matrice de priorité ;
- éviter de confondre urgence ressentie et urgence réelle ;
- identifier un incident critique ;
- comprendre le principe d’escalade ;
- distinguer escalade fonctionnelle et hiérarchique ;
- transmettre un ticket avec les informations nécessaires ;
- réévaluer la priorité lorsque la situation évolue.
1. Pourquoi prioriser les incidents ?
Un service support peut recevoir plusieurs demandes simultanément.
Par exemple :
- un utilisateur souhaite installer un logiciel ;
- une imprimante individuelle ne fonctionne plus ;
- dix utilisateurs n’accèdent plus à une application ;
- tout un site est privé de réseau.
Traiter les tickets uniquement dans leur ordre d’arrivée n’est donc pas toujours adapté.
Le technicien doit déterminer quelles situations nécessitent une prise en charge plus rapide.
🔧 Réflexe technicien
La priorité d’un ticket ne dépend pas uniquement de la personne qui le signale ou de la manière dont elle exprime son urgence.
2. Qu’est-ce que l’impact ?
L’impact correspond à l’importance des conséquences de l’incident sur l’organisation.
Pour l’évaluer, on peut notamment se demander :
- combien d’utilisateurs sont concernés ;
- quel service est touché ;
- si une activité métier importante est bloquée ;
- si une solution de contournement existe ;
- si plusieurs équipements sont affectés.
Impact faible
Exemple :
Un utilisateur ne peut plus utiliser sa seconde imprimante mais dispose d’une autre imprimante fonctionnelle.
Impact moyen
Exemple :
Plusieurs utilisateurs d’un service ne peuvent plus utiliser une application.
Impact élevé
Exemple :
L’ensemble d’un site ne dispose plus d’accès au réseau.
🔧 Réflexe technicien
Une question essentielle est : combien de personnes ou de services sont réellement affectés ?
3. Qu’est-ce que l’urgence ?
L’urgence correspond au délai dans lequel l’incident doit être traité avant que ses conséquences deviennent importantes.
Elle dépend notamment :
- du niveau de blocage ;
- de l’existence d’une solution de contournement ;
- d’une échéance proche ;
- de l’activité concernée.
Urgence faible
Un utilisateur souhaite faire corriger un affichage gênant mais peut continuer à travailler.
Urgence moyenne
Une fonction importante est indisponible mais une solution temporaire existe.
Urgence élevée
Une activité essentielle est totalement bloquée et aucune solution de contournement n’existe.
4. Impact et urgence ne sont pas la même chose
Un incident peut avoir :
- un impact faible mais une urgence élevée ;
- un impact élevé mais une urgence modérée ;
- un impact et une urgence élevés.
Exemple 1
Le poste d’un seul utilisateur est en panne juste avant une opération indispensable qu’il est seul à pouvoir réaliser.
L’impact en nombre d’utilisateurs est faible, mais l’urgence peut être importante.
Exemple 2
Une application secondaire est indisponible pour cinquante utilisateurs, mais personne ne doit l’utiliser avant le lendemain.
L’impact est élevé, mais l’urgence immédiate peut être plus faible.
🔧 Réflexe technicien
Ne pas évaluer uniquement le nombre d’utilisateurs. Il faut aussi comprendre l’activité réellement bloquée.
5. Qu’est-ce que la priorité ?
La priorité détermine l’ordre et la rapidité de traitement d’un ticket.
Elle est généralement calculée ou déterminée à partir de :
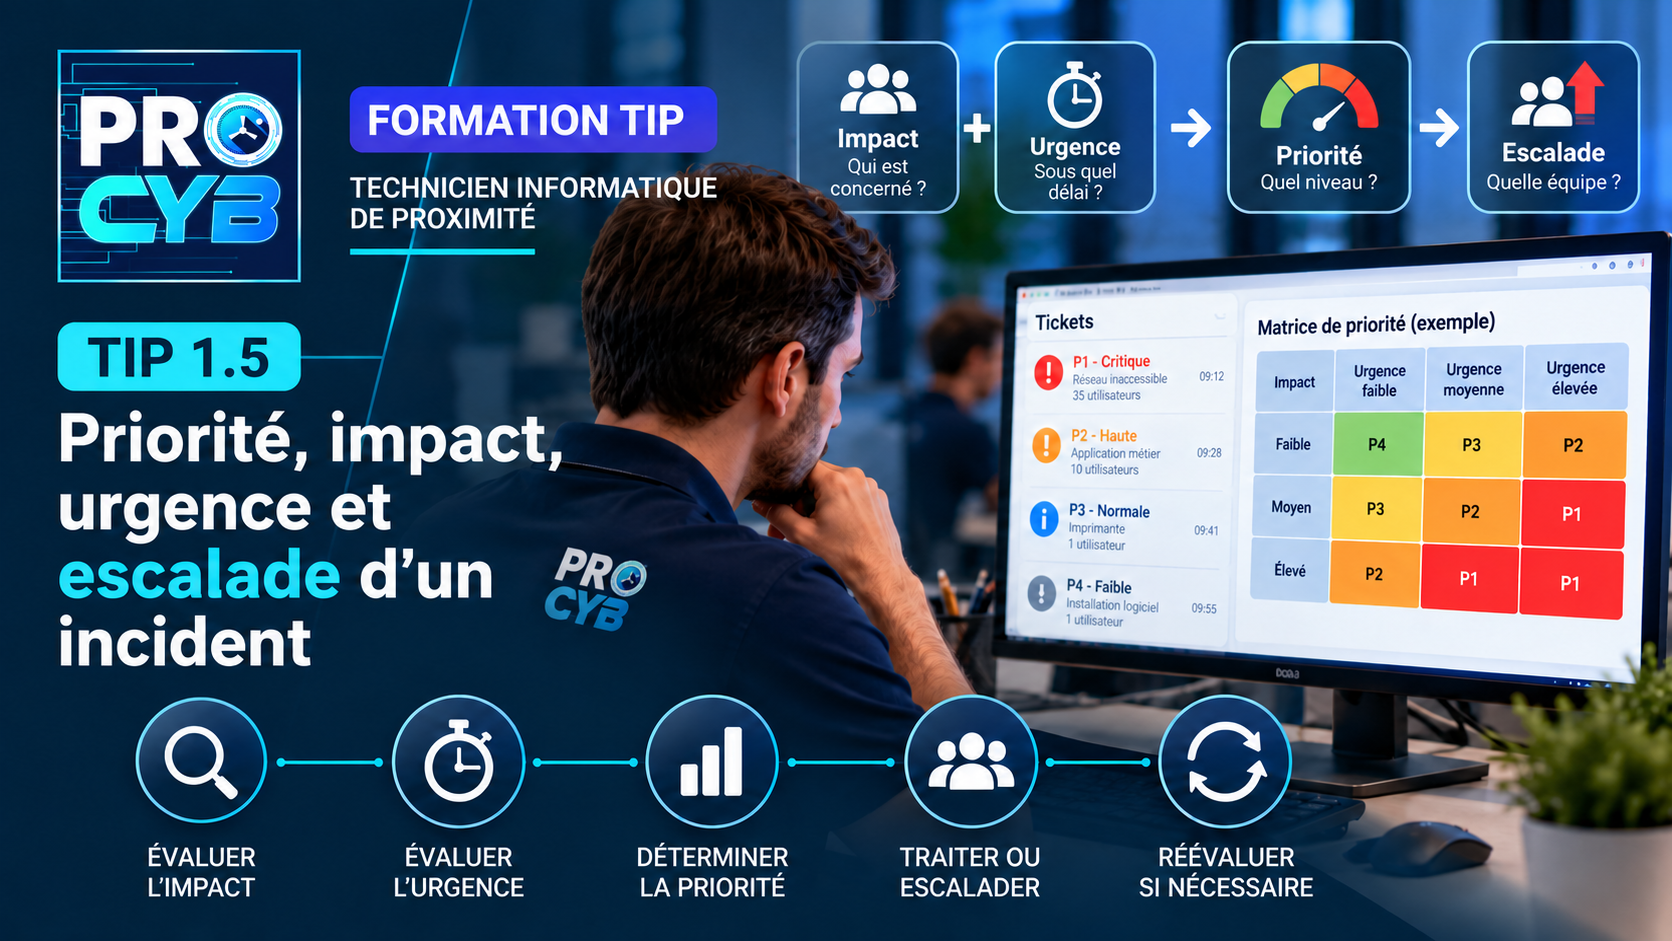
Impact + Urgence → Priorité
La méthode exacte dépend de l’organisation et de l’outil de ticketing utilisé.
On rencontre souvent des niveaux comme :
- P1 – Critique ;
- P2 – Haute ;
- P3 – Normale ;
- P4 – Faible.
D’autres organisations utilisent simplement :
- Faible ;
- Normale ;
- Haute ;
- Critique.
6. Exemple de matrice de priorité
Voici un exemple pédagogique simple.
| Impact | Urgence faible | Urgence moyenne | Urgence élevée |
|---|---|---|---|
| Faible | P4 – Faible | P3 – Normale | P2 – Haute |
| Moyen | P3 – Normale | P2 – Haute | P1 – Critique |
| Élevé | P2 – Haute | P1 – Critique | P1 – Critique |
Cette matrice est un exemple de fonctionnement.
Dans une entreprise réelle, il faut appliquer la matrice et les règles définies par l’organisation.
🔧 Réflexe technicien
Ne jamais inventer sa propre priorité si une procédure ou une matrice officielle existe.
7. Urgence ressentie et urgence réelle
Un utilisateur peut présenter chaque demande comme urgente.
Par exemple :
« C’est extrêmement urgent, mon deuxième écran ne fonctionne plus ! »
Le technicien doit rester à l’écoute tout en évaluant objectivement la situation.
Il peut demander :
- Pouvez-vous continuer à travailler avec l’écran principal ?
- Une activité particulière est-elle bloquée ?
- Existe-t-il un autre poste disponible ?
- Une échéance métier immédiate est-elle concernée ?
Si l’utilisateur peut poursuivre son activité, la priorité réelle peut être moins élevée que l’urgence ressentie.
À l’inverse, un utilisateur calme peut signaler un incident réellement critique.
8. Identifier un incident critique
Certains incidents doivent immédiatement attirer l’attention.
Par exemple :
- indisponibilité réseau générale ;
- application métier essentielle indisponible pour de nombreux utilisateurs ;
- serveur critique inaccessible ;
- incident de cybersécurité potentiel ;
- perte ou corruption importante de données ;
- service indispensable totalement interrompu.
Le technicien doit alors appliquer la procédure prévue par l’organisation.
Cela peut nécessiter :
- une escalade immédiate ;
- l’information d’un responsable ;
- la mobilisation d’une équipe spécialisée ;
- une communication régulière aux utilisateurs.
🔧 Réflexe technicien
Lorsqu’un incident semble majeur, ne pas multiplier les manipulations isolées sur plusieurs postes avant d’avoir vérifié si le problème est global.
9. Qu’est-ce qu’une escalade ?
Une escalade consiste à transmettre ou signaler un incident lorsqu’il dépasse :
- les compétences du technicien ;
- ses droits ;
- son périmètre ;
- le délai acceptable ;
- le niveau de criticité qu’il peut gérer seul.
L’objectif n’est pas de se débarrasser du ticket.
L’objectif est de permettre sa prise en charge par la personne ou l’équipe la plus adaptée.
10. L’escalade fonctionnelle
L’escalade fonctionnelle consiste à transmettre le ticket à une équipe possédant davantage de compétences ou de droits techniques.
Exemple
Le technicien constate :
- que le poste fonctionne ;
- que le réseau fonctionne ;
- que l’utilisateur reçoit « Accès refusé » sur un partage ;
- qu’il ne possède pas les droits nécessaires pour modifier les groupes Active Directory.
Le ticket peut être transmis à :
> l’équipe systèmes / Active Directory.Il s’agit d’une escalade fonctionnelle.
11. L’escalade hiérarchique
L’escalade hiérarchique consiste à informer un responsable lorsqu’un incident nécessite une décision, une coordination ou une attention particulière.
Elle peut être nécessaire lorsqu’un incident :
- devient critique ;
- dépasse un délai important ;
- affecte fortement l’activité ;
- concerne plusieurs équipes ;
- risque d’avoir des conséquences importantes.
Elle ne remplace pas nécessairement l’escalade technique.
Les deux peuvent être utilisées simultanément.
12. Préparer une bonne escalade
Une escalade ne doit pas se résumer à :
« Je ne trouve pas. À voir avec l’administrateur. »
Le ticket doit permettre à l’équipe suivante de poursuivre le travail.
Il faut transmettre :
- l’utilisateur concerné ;
- le poste ou l’équipement ;
- le symptôme exact ;
- la date d’apparition ;
- l’étendue du problème ;
- les tests réalisés ;
- les résultats obtenus ;
- les actions déjà effectuées ;
- la raison de l’escalade.
Exemple
Incident : accès refusé au partage BUDGET.
Utilisateur : Paul Bernard.
Poste : PC-FIN-15.
Tests :
- connexion réseau OK ;
- SRV-FICHIERS joignable ;
- partage accessible depuis un poste voisin ;
- incident limité au compte de Paul Bernard.
Action réalisée : fermeture/réouverture de session sans amélioration.
Escalade : vérification de l’appartenance aux groupes AD nécessaire, droits insuffisants au niveau support.
13. Réévaluer la priorité
La priorité d’un ticket peut évoluer.
Exemple
À 9 h :
Un utilisateur indique qu’une application fonctionne lentement.
Ticket créé avec priorité normale.
À 9 h 30 :
Quarante utilisateurs indiquent qu’ils ne peuvent plus utiliser cette application.
L’impact a fortement augmenté.
La priorité doit donc être réévaluée selon les règles de l’organisation.
🔧 Réflexe technicien
La priorité n’est pas nécessairement figée lors de la création du ticket.
14. Manipulation pratique – Évaluer des incidents
Pour chaque situation, détermine :
- l’impact ;
- l’urgence ;
- une priorité probable ;
- si une escalade semble nécessaire.
Situation 1
Un utilisateur ne peut plus utiliser son second écran. Son écran principal fonctionne normalement.
Situation 2
Tout le service Comptabilité ne peut plus accéder à son application métier pendant la préparation de la clôture mensuelle.
Situation 3
Un utilisateur demande l’installation d’un logiciel dont il aura besoin dans trois semaines.
Situation 4
Tous les utilisateurs d’un bâtiment perdent simultanément l’accès au réseau.
Situation 5
Un utilisateur signale qu’un fichier suspect vient de chiffrer plusieurs documents de son poste.
✅ Afficher le corrigé
Situation 1
Impact faible et urgence généralement faible à moyenne si l’utilisateur peut poursuivre son activité. Priorité probablement faible ou normale.
Situation 2
Impact élevé et urgence élevée : de nombreux utilisateurs et une activité métier importante sont bloqués. Priorité élevée ou critique selon la matrice de l’organisation.
Situation 3
Il s’agit d’une demande de service avec une urgence faible puisque l’échéance est éloignée.
Situation 4
Impact élevé et urgence élevée. L’incident est probablement critique et nécessite une escalade rapide vers l’équipe réseau.
Situation 5
Un chiffrement inhabituel de fichiers peut indiquer un incident de cybersécurité. La procédure de sécurité doit être appliquée immédiatement et l’incident escaladé vers l’équipe compétente.
15. TP – Prioriser plusieurs tickets
Situation
Tu arrives au support à 9 h et cinq tickets sont en attente.
Ticket A
Un utilisateur souhaite installer une nouvelle police de caractères pour une présentation prévue la semaine prochaine.
Ticket B
Une utilisatrice ne peut plus imprimer, mais une seconde imprimante du service est disponible.
Ticket C
Le réseau est inaccessible pour les 35 utilisateurs du site de Vannes.
Ticket D
Le directeur indique que son deuxième écran ne fonctionne plus. Son ordinateur et son écran principal fonctionnent.
Ticket E
Trois utilisateurs indiquent que leurs fichiers viennent de prendre une extension inhabituelle et qu’un message réclame un paiement.
1. Quels tickets traiterais-tu ou escaladerais-tu en priorité ?
2. Pourquoi le ticket D ne doit-il pas automatiquement devenir prioritaire parce qu’il concerne le directeur ?
3. Quel est l’impact du ticket C ?
4. Existe-t-il une solution de contournement pour le ticket B ? Quel effet cela peut-il avoir sur l’urgence ?
5. Pourquoi le ticket E nécessite-t-il une réaction particulièrement rapide ?
6. Quelle équipe pourrait recevoir l’escalade du ticket C ?
7. Quelles informations faut-il transmettre lors de cette escalade ?
8. Après 20 minutes, tu apprends que la panne réseau concerne finalement trois sites et 200 utilisateurs. Que dois-tu faire concernant la priorité ?
✅ Afficher le corrigé
1. Tickets E et C
Le ticket E présente des signes possibles de ransomware et nécessite l’application immédiate de la procédure de sécurité. Le ticket C touche 35 utilisateurs et bloque le réseau d’un site entier.
2. La fonction de l’utilisateur ne détermine pas seule la priorité
La priorité doit être évaluée selon l’impact, l’urgence et les règles de l’organisation.
3. Impact élevé
Les 35 utilisateurs du site sont concernés par la perte du réseau.
4. Oui
Une seconde imprimante est disponible. La présence d’une solution de contournement réduit généralement l’urgence.
5. Suspicion d’incident de cybersécurité
Le chiffrement des fichiers et la demande de paiement peuvent indiquer un ransomware susceptible de se propager ou d’affecter d’autres ressources.
6. Équipe réseau / infrastructure
Le ticket doit être transmis vers l’équipe disposant des outils et droits nécessaires pour diagnostiquer l’infrastructure réseau.
7. Informations à transmettre
Site concerné, nombre d’utilisateurs, heure d’apparition, symptômes, équipements ou services touchés, tests effectués et résultats obtenus.
8. Réévaluer immédiatement la priorité
L’impact a considérablement augmenté. La priorité doit être adaptée selon la matrice et la procédure de gestion des incidents de l’organisation.
🎓 Point examen
Face à plusieurs demandes simultanées, le technicien doit savoir justifier l’ordre de traitement.
Il faut retenir :
- impact → conséquences et étendue de l’incident ;
- urgence → rapidité avec laquelle il faut intervenir ;
- priorité → niveau de traitement résultant généralement de l’impact et de l’urgence ;
- escalade fonctionnelle → transmission vers une équipe plus spécialisée ;
- escalade hiérarchique → information ou mobilisation d’un responsable ;
- la priorité peut évoluer si l’incident s’étend.
La logique à retenir est :
Évaluer l’impact → Évaluer l’urgence → Déterminer la priorité → Traiter ou escalader → Réévaluer.
✅ À retenir
Impact → importance des conséquences de l’incident sur les utilisateurs et l’activité.
Urgence → rapidité avec laquelle l’incident doit être pris en charge.
Priorité → détermine l’ordre et la rapidité de traitement.
Principe → impact + urgence permettent généralement de déterminer la priorité.
Contournement → une solution temporaire peut réduire l’urgence.
Incident collectif → vérifier rapidement si plusieurs utilisateurs ou services sont touchés.
Incident critique → appliquer la procédure spécifique et escalader rapidement.
Escalade fonctionnelle → transférer vers une équipe disposant des compétences ou droits nécessaires.
Escalade hiérarchique → informer un responsable lorsqu’une coordination ou une décision est nécessaire.
Bonne escalade → transmettre les symptômes, le contexte, les tests et les résultats déjà obtenus.
Priorité dynamique → réévaluer si l’impact ou l’urgence change.
Méthode → impact → urgence → priorité → traitement/escalade → réévaluation.
Quiz final
1. Que représente l’impact d’un incident ?
A. Le niveau technique du technicien
B. Les conséquences de l’incident sur l’organisation
C. L’heure de création du ticket
D. Le nom de l’utilisateur
2. Que représente l’urgence ?
A. Le délai dans lequel l’incident doit être traité
B. Le nombre de techniciens disponibles
C. La taille du disque dur
D. Le numéro du ticket
3. La priorité dépend généralement :
A. Du nom de l’utilisateur uniquement
B. De l’impact et de l’urgence
C. Du modèle de l’ordinateur uniquement
D. De l’ordre alphabétique
4. Un utilisateur dit que son ticket est urgent. Le technicien doit :
A. Lui attribuer automatiquement la priorité maximale
B. Évaluer objectivement l’impact et l’urgence
C. Fermer le ticket
D. Refuser la demande
5. Une solution de contournement peut :
A. Réduire l’urgence d’un incident
B. Augmenter toujours la priorité
C. Supprimer le ticket automatiquement
D. Empêcher toute escalade
6. Une escalade fonctionnelle consiste à :
A. Transmettre le ticket vers une équipe disposant des compétences nécessaires
B. Prévenir uniquement le directeur
C. Fermer le ticket
D. Réinstaller systématiquement Windows
7. Une escalade hiérarchique consiste notamment à :
A. Informer un responsable lorsqu’une décision ou coordination est nécessaire
B. Changer l’adresse IP
C. Modifier les permissions NTFS
D. Ajouter une imprimante
8. Que faut-il transmettre lors d’une escalade ?
A. Uniquement « cela ne fonctionne pas »
B. Les symptômes, le contexte, les tests et leurs résultats
C. Aucun détail
D. Seulement le nom de l’utilisateur
9. La priorité d’un ticket peut-elle évoluer ?
A. Non, jamais
B. Oui, si l’impact ou l’urgence évolue
C. Seulement après fermeture
D. Seulement si l’utilisateur change de poste
10. Quelle séquence est la plus adaptée ?
A. Urgence ressentie → priorité maximale
B. Impact → urgence → priorité → traitement/escalade → réévaluation
C. Escalade → création → diagnostic
D. Clôture → diagnostic → priorité
✅ Afficher le corrigé
1. B – Les conséquences de l’incident sur l’organisation
L’impact tient notamment compte du nombre d’utilisateurs et de l’importance de l’activité affectée.
2. A – Le délai dans lequel l’incident doit être traité
L’urgence dépend notamment du niveau de blocage et de l’existence d’une solution de contournement.
3. B – De l’impact et de l’urgence
Les organisations utilisent généralement ces deux critères pour déterminer le niveau de priorité.
4. B – Évaluer objectivement l’impact et l’urgence
L’urgence ressentie par l’utilisateur ne suffit pas à définir la priorité.
5. A – Réduire l’urgence d’un incident
Si l’utilisateur peut poursuivre son activité autrement, le besoin d’intervention immédiate peut être réduit.
6. A – Transmettre le ticket vers une équipe disposant des compétences nécessaires
C’est le principe de l’escalade fonctionnelle.
7. A – Informer un responsable lorsqu’une décision ou coordination est nécessaire
Il s’agit d’une escalade hiérarchique.
8. B – Les symptômes, le contexte, les tests et leurs résultats
Une bonne transmission évite à l’équipe suivante de recommencer inutilement le diagnostic.
9. B – Oui, si l’impact ou l’urgence évolue
Une panne initialement limitée peut devenir un incident majeur.
10. B – Impact → urgence → priorité → traitement/escalade → réévaluation
Cette logique permet d’organiser efficacement la prise en charge des incidents.
📄 Fiche de révision
Retrouvez l’essentiel de ce cours dans une fiche synthétique à conserver ou à imprimer pour vos révisions.